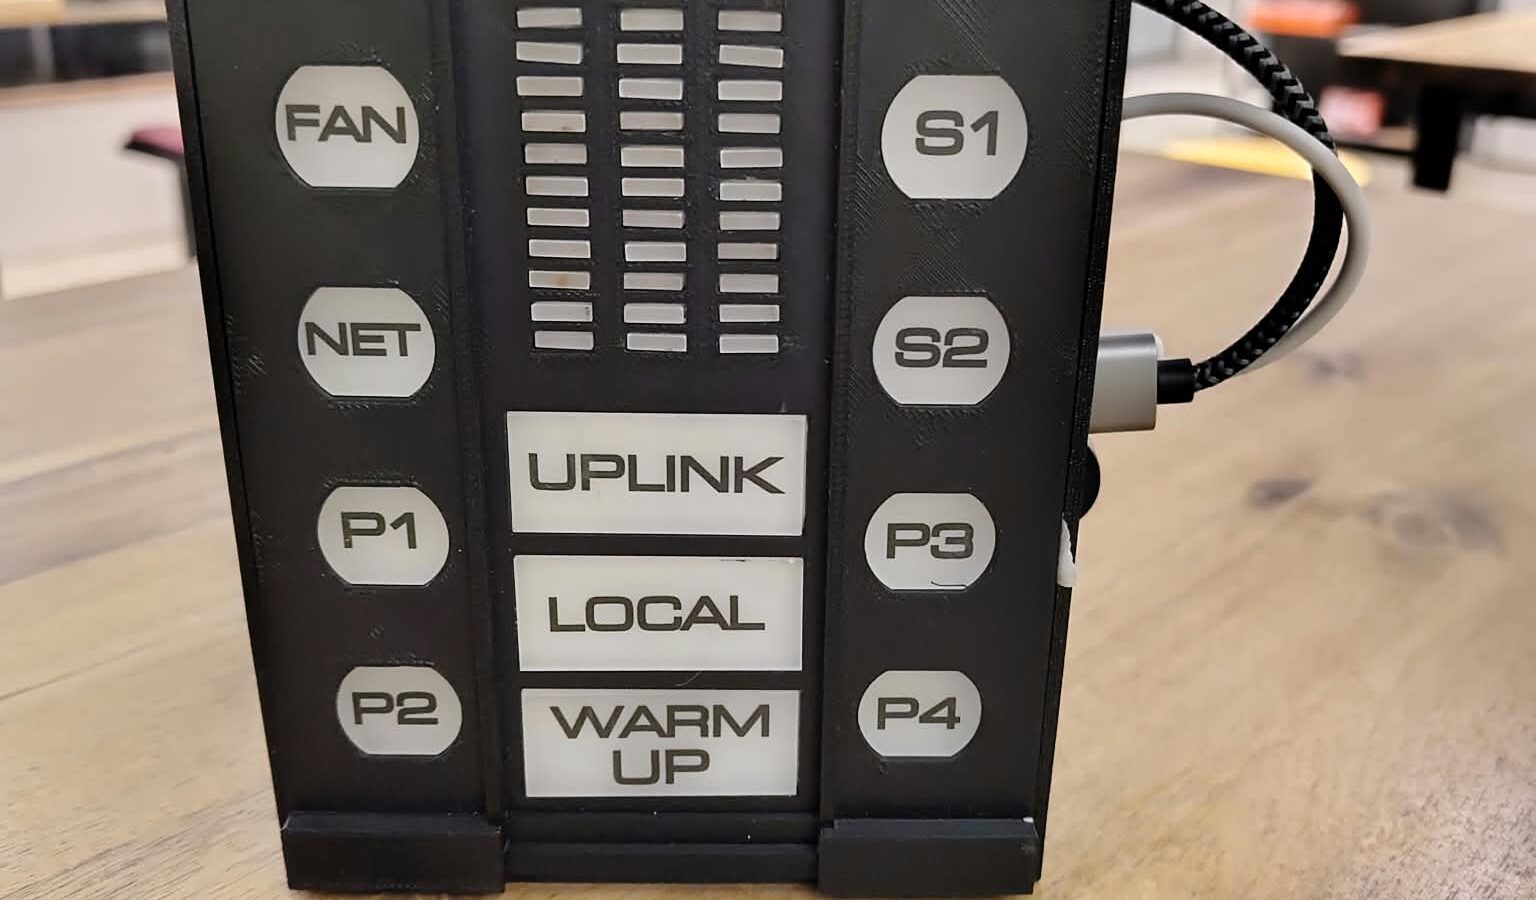
Wer mit Knight Rider aufgewachsen ist, kennt ihn: den roten Sprachmodulator in der Mittelkonsole, dessen drei Balken im Takt von KITTs Stimme aufleuchten. Genau so eine Box steht jetzt auf meiner Werkbank – nur dass sie nicht bloß blinkt. Man spricht sie mit „KITT“ an, sie versteht die Frage, denkt kurz nach und antwortet mit KITTs Stimme. Und zwar offline: Spracherkennung, Sprachmodell und Stimme laufen direkt in der Box.
In diesem Beitrag geht es nicht um jede Zeile Code, sondern darum, wie die Box aufgebaut ist und wie die Technik dahinter zusammenspielt.
Was die Box kann
- Fragen beantworten – Wissen, Alltag, Technik, Gespräch. Mit dem trockenen Humor und der höflichen Art, die man von KITT kennt.
- Mehrsprachig antworten – KITT antwortet in der Sprache, in der er gefragt wird: Deutsch, Englisch, Französisch, Spanisch, Portugiesisch, Niederländisch und (mit Abstrichen) Luxemburgisch.
- Dolmetschen – „KITT, dolmetsche zwischen Deutsch und Französisch.“ Danach wird jeder Satz in die jeweils andere Sprache übertragen.
- Über sich selbst Auskunft geben – auf „Wie funktionierst du?“, nach Uhrzeit oder Datum antwortet die Box ohne Sprachmodell, also sofort.
- Laute Umgebungen – statt auf das Weckwort zu warten, hört die Box auf Tastendruck zu. In einer Messehalle mit 70 bis 80 dB Grundpegel ist ein Taster schlicht die zuverlässigste Lösung.
Die Hardware
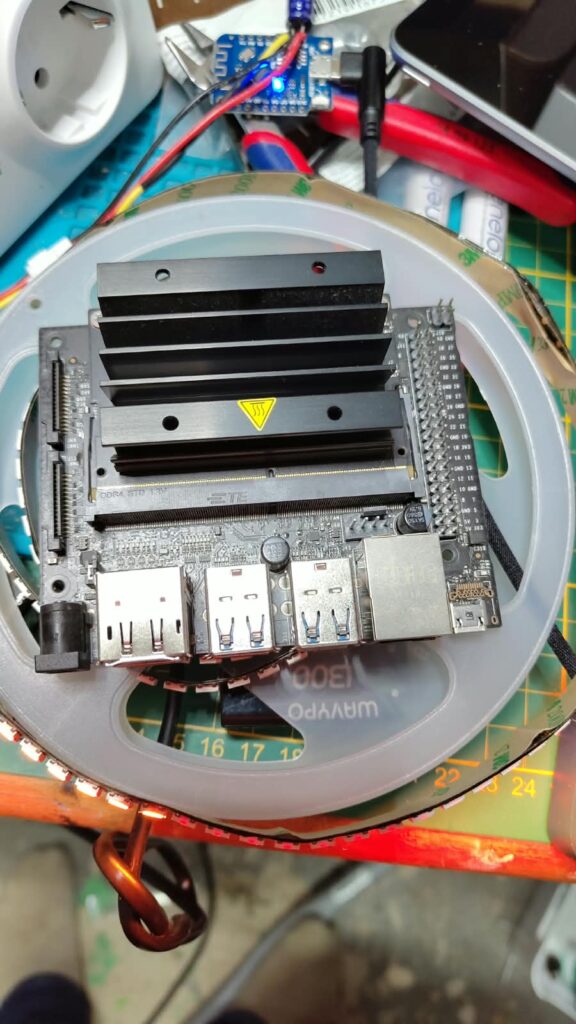
Das Herzstück ist ein NVIDIA Jetson Orin Nano mit 8 GB Speicher. Auf diesem kleinen Board laufen Spracherkennung, Sprachmodell und Sprachausgabe gleichzeitig – das ist auf 8 GB geteiltem Speicher durchaus eine Übung in Sparsamkeit.
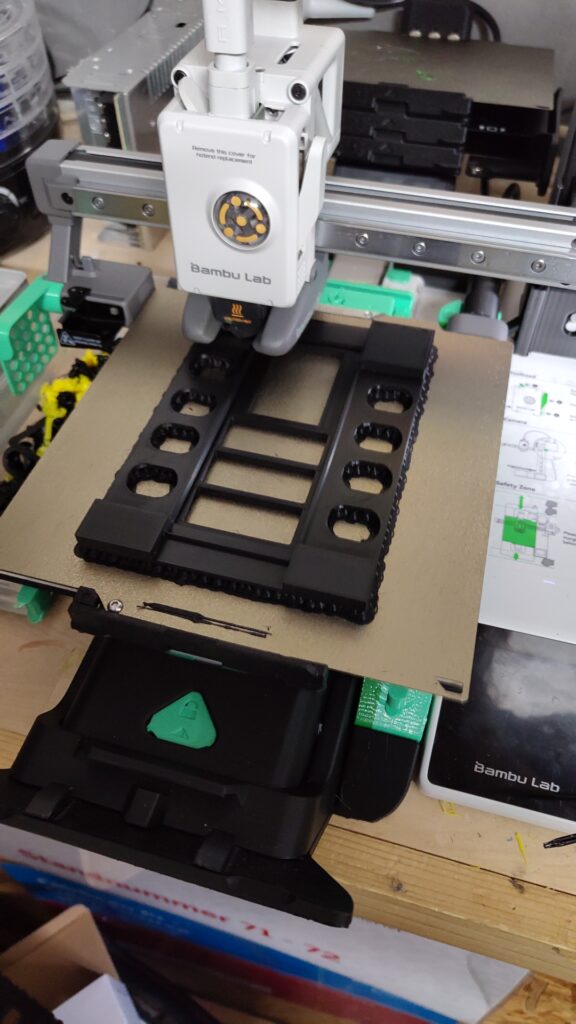
Der Ton läuft über eine einfache USB-Soundkarte. Hinein kommt das Signal einer Elektret-Mikrofonkapsel, die direkt in der Frontplatte sitzt, hinaus geht es über einen kleinen Audioverstärker an einen Lautsprecher. Das Gehäuse stammt aus dem 3D-Drucker.
Für die Lichter sorgt ein Wemos D1 mini mit WLED und ein einziger Strang WS2812-LEDs: vorne die drei Sprachbalken mit je acht LEDs, dahinter die elf beleuchteten Tasten – FAN, NET, P1 bis P4, S1, S2 und die drei Modus-Felder UPLINK, LOCAL und WARM UP. Das Vorbild ist die Mittelkonsole aus der Serie, die Beschriftungen habe ich an meine Box angepasst. Zusammen sind das 38 LEDs. Der Wemos hängt per USB am Jetson; der Jetson berechnet die Pixel selbst und schickt sie seriell hinüber. So braucht das Panel kein WLAN – auf Messen ein echter Vorteil.
Vom gesprochenen Wort zur Antwort
Jede Runde folgt derselben Kette:
Mikrofon → Sprache erkannt → Whisper → „KITT“? → Sprachmodell → Stimme- Zuhören: Ob jemand spricht, erkennt die Box an der Signalenergie. Die Schwelle liegt relativ über dem Grundrauschen, das beim Start gemessen wird – so muss man sie nicht für jeden Raum neu einstellen. Ein kurzer Vorlauf von 300 ms wird mitgeschnitten, sonst fehlt der erste Laut.
- Verstehen: Whisper wandelt die Aufnahme in Text um und erkennt dabei auch die Sprache.
- Angesprochen? Für das Weckwort gibt es kein eigenes Modell – es wird aus dem Transkript gelesen. Weil Whisper ein kurzes „KITT“ selten zweimal gleich schreibt, wird unscharf verglichen: „Kit“, „Kid“ oder „Kitty“ zählen auch. Eine Sperrliste verhindert, dass ein harmloses „Gut, dann …“ als Ansprache durchgeht.
- Denken und sprechen: Das Sprachmodell formuliert die Antwort, die Stimme spricht sie – dazu gleich mehr.
Ein Detail, das man leicht vergisst: Während KITT spricht, ist das Mikrofon stumm geschaltet. Sonst hört die Box ihre eigene Antwort, transkribiert sie – und antwortet sich selbst.
Das Gehirn: klein an Bord, groß im Netz
An Bord läuft ein kleines Sprachmodell, Gemma 4 E2B, über llama-server direkt auf dem Jetson. Damit ist die Box vollständig autark.
Ist mein Rechner „Ralf“ im Netz erreichbar – ein PC mit zwei AMD-Grafikkarten –, geht die Frage stattdessen dorthin. Dort antwortet ein deutlich größeres Gemma-4-Modell mit 26 Milliarden Parametern, und davor sitzt der Agent Hermes: Er gibt KITT ein Gedächtnis und die Möglichkeit, im Web zu suchen, über eine lokal betriebene Suchmaschine. Fällt Ralf aus, übernimmt ohne Unterbrechung wieder das Modell an Bord.
Wer gerade denkt, sieht man am Panel: LOCAL steht für die Bordsysteme, UPLINK für die externe Recheneinheit. Den Wechsel sagt KITT vorher an, ganz in seiner Art: „Ich schalte die externe Recheneinheit auf. Etwas mehr Rechenleistung hat noch nie geschadet.“
Spannend war die Arbeit am Charakter. Ein Systemprompt beschreibt, wer KITT ist – höflich, trocken, auf die Sicherheit seines Gegenübers bedacht. Bei kleinen Modellen wirken aber Beispieldialoge viel stärker als Beschreibungen. Ein Beispiel: Die Anweisung, in der Sprache der Frage zu antworten, hat das Modell bei einer französischen Frage in keinem von drei Versuchen befolgt. Mit ein paar französischen Beispieldialogen klappte es dreimal von dreimal. Kleine Modelle machen nach, was man ihnen vormacht – nicht, was man ihnen aufträgt.
Die Stimme
Für die Stimme nutze ich Qwen3-TTS, ein Sprachsynthese-Modell, das eine Stimme aus einer kurzen Referenzaufnahme nachbildet. Ein Ausschnitt von gut sechs Sekunden genügt – trainiert wird dafür nichts. Ein paar Kniffe waren trotzdem nötig:
- Vor der Referenzaufnahme stehen 250 ms Stille. Ohne dieses Polster setzt das Modell vor jeden Satz ein kurzes Knacken, das wie ein „t“ klingt.
- Der Name steht in allen Texten als Wort „KITT“, nicht als „K.I.T.T.“ – sonst buchstabiert die Stimme ihn aus.
- Für Fremdsprachen lässt sich je Sprache eine eigene Referenz hinterlegen, damit KITT Englisch nicht mit deutschem Akzent spricht.
Damit man nicht lange auf die Antwort warten muss, wird auf zwei Ebenen gestreamt: Das Sprachmodell liefert Satz für Satz, und jeder Satz wird blockweise erzeugt und sofort abgespielt. Der erste Satz läuft also schon, während das Modell noch am zweiten schreibt. Auf dem Entwicklungsrechner ist so nach knapp einer Sekunde der erste Ton zu hören. Ist Ralf erreichbar, übernimmt auch dort eine Grafikkarte die Sprachausgabe, deutlich schneller als der Jetson.
Zum Schluss durchläuft die Stimme noch eine kleine Klangkette: Hochpass, etwas Präsenz bei 3 kHz, Kompressor und Limiter. Das gibt den typischen Bordcomputer-Klang – vor allem aber rund 10 dB mehr mittlere Lautstärke. An einem kleinen Lautsprecher mit wenigen Watt entscheidet genau die über die Verständlichkeit.
Die Lichter
Die drei Sprachbalken leuchten hinter einer Blende mit Schlitzen und bewegen sich mit KITTs Stimme, und zwar mit dem Signal, das die Box selbst erzeugt, nicht mit einem Mikrofon am Panel. So reagieren sie nur auf KITT und nicht auf Hallenlärm oder den Nachbarstand. Der Pegel wird dabei abgegriffen, bevor die Klangkette komprimiert, sonst stünden die Balken fast die ganze Zeit am Anschlag.
Beim Einschalten läuft die Startsequenz der Mittelkonsole ab, wie im Original. Die habe ich an einer Filmaufnahme ausgemessen: Die Tasten gehen paarweise an – FAN und S1, dann NET und S2, P1 und P3, P2 und P4 –, jeweils im Abstand von gut 0,75 Sekunden und begleitet von einem Zweiklang. Zum Schluss leuchtet LOCAL, und zwar ohne Ton. Kleine Überraschung beim Nachmessen: Die Töne sind nicht nach der üblichen Tonleiter gestimmt. Wer sie auf die nächsten Noten rundet, liegt bis zu einem halben Halbton daneben.
Experiment: KITT fürs Smartphone
Als Proof of Concept habe ich KITT außerdem aufs Smartphone gebracht – eine Android-App nur für mein eigenes Telefon, nicht im App Store. Das Telefon hört zu und erkennt die Sprache per Whisper direkt auf dem Gerät, KITT selbst läuft auf Ralf und ist unterwegs über einen WireGuard-Tunnel erreichbar. In der Halterung zeigt das Telefon die drei Balken auf Schwarz, unter Android Auto die ganze Voice-Box mit ihren Tastenreihen.
Fazit
Die KITT Voice Box ist eines dieser Projekte, bei denen Maker-Spaß und ernsthafte Technik zusammenkommen: 3D-Druck, LEDs und Lötkolben auf der einen Seite, lokale Spracherkennung, ein Sprachmodell und eine geklonte Stimme auf der anderen. Und sie zeigt, wie viel heute auf einem kleinen Board ohne Cloud möglich ist.